Java Flight Recorder: la scatola nera nascosta dentro Java 11

Quando si parla delle novità introdotte con Java 11 vengono spesso citati nuovi metodi della classe String, il nuovo HttpClient o alcuni miglioramenti alla JVM. Esiste però una funzionalità molto più interessante, soprattutto per chi sviluppa applicazioni backend: Java Flight Recorder, abbreviato in JFR.

Il nome non è casuale. Il concetto è molto simile a quello della scatola nera di un aereo: mentre un’applicazione Java è in esecuzione, la JVM può registrare una grande quantità di informazioni sul proprio comportamento. Thread, memoria, Garbage Collector, lock, eccezioni, utilizzo della CPU, allocazioni di oggetti e molte altre informazioni possono essere raccolte e analizzate successivamente.

La cosa particolarmente interessante è che tutto questo può essere fatto senza modificare il codice dell’applicazione.

Java Flight Recorder non nasce realmente con Java 11

Una precisazione è importante. Flight Recorder esisteva già prima di Java 11. La grande novità arrivata con Java 11 è rappresentata dal JEP 328, con il quale Flight Recorder è stato portato nell’ecosistema OpenJDK.

Da quel momento JFR è diventato uno degli strumenti più interessanti disponibili direttamente nella piattaforma Java per effettuare diagnostica e profiling delle applicazioni.

Non stiamo quindi parlando semplicemente di una nuova API, ma di uno strumento integrato profondamente nella JVM.

Ma cosa registra esattamente?

Durante l’esecuzione di un’applicazione, Java Flight Recorder raccoglie degli eventi. Ogni evento descrive qualcosa che è avvenuto all’interno della JVM o dell’applicazione.

CPU
│
├── Thread
│
├── Garbage Collection
│
├── Allocazioni di memoria
│
├── Lock e sincronizzazione
│
├── File I/O
│
├── Socket I/O
│
├── Eccezioni
│
├── Class Loading
│
└── Attività della JVM

Questo significa che davanti a un’applicazione che improvvisamente diventa lenta non siamo più costretti a basarci esclusivamente sui log o su supposizioni. Possiamo osservare ciò che è realmente successo all’interno della JVM.

Registrare un’applicazione è sorprendentemente semplice

Supponiamo di avere una normale applicazione Java distribuita come file JAR. Con Java 11 possiamo avviarla chiedendo contemporaneamente alla JVM di effettuare una registrazione:

java -XX:StartFlightRecording=duration=60s,filename=recording.jfr \
     -jar applicazione.jar

Con questo comando stiamo dicendo alla JVM:

Avvia l'applicazione
        │
        ▼
Registra ciò che accade
        │
        ▼
Continua per 60 secondi
        │
        ▼
Salva tutto in recording.jfr

Al termine avremo quindi un file:

recording.jfr

che contiene gli eventi raccolti durante quel minuto di esecuzione. L’opzione -XX:StartFlightRecording è documentata direttamente tra le opzioni della JVM di Java 11 e permette di configurare durata, nome del file, profilo di registrazione e altri parametri.

Possiamo registrare anche una JVM già avviata

Qui la faccenda diventa ancora più interessante. Immaginiamo che un backend sia già in esecuzione e improvvisamente inizi a mostrare problemi di performance. Non è obbligatorio riavviarlo.

Possiamo individuare il PID del processo Java:

jcmd

e supponiamo di ottenere:

18342 com.cutalab.Application

Possiamo quindi avviare una registrazione direttamente sul processo:

jcmd 18342 JFR.start name=analisi settings=profile duration=60s filename=analisi.jfr

In altre parole, possiamo collegarci a una JVM già attiva e dirle: registrami cosa sta succedendo adesso.

Ed entra in scena JDK Mission Control

Il file .jfr è solo la registrazione grezza. Per analizzarlo possiamo utilizzare JDK Mission Control, spesso abbreviato semplicemente in JMC.

Mission Control permette di trasformare migliaia di eventi della JVM in grafici, timeline, stack trace e analisi molto più semplici da interpretare.
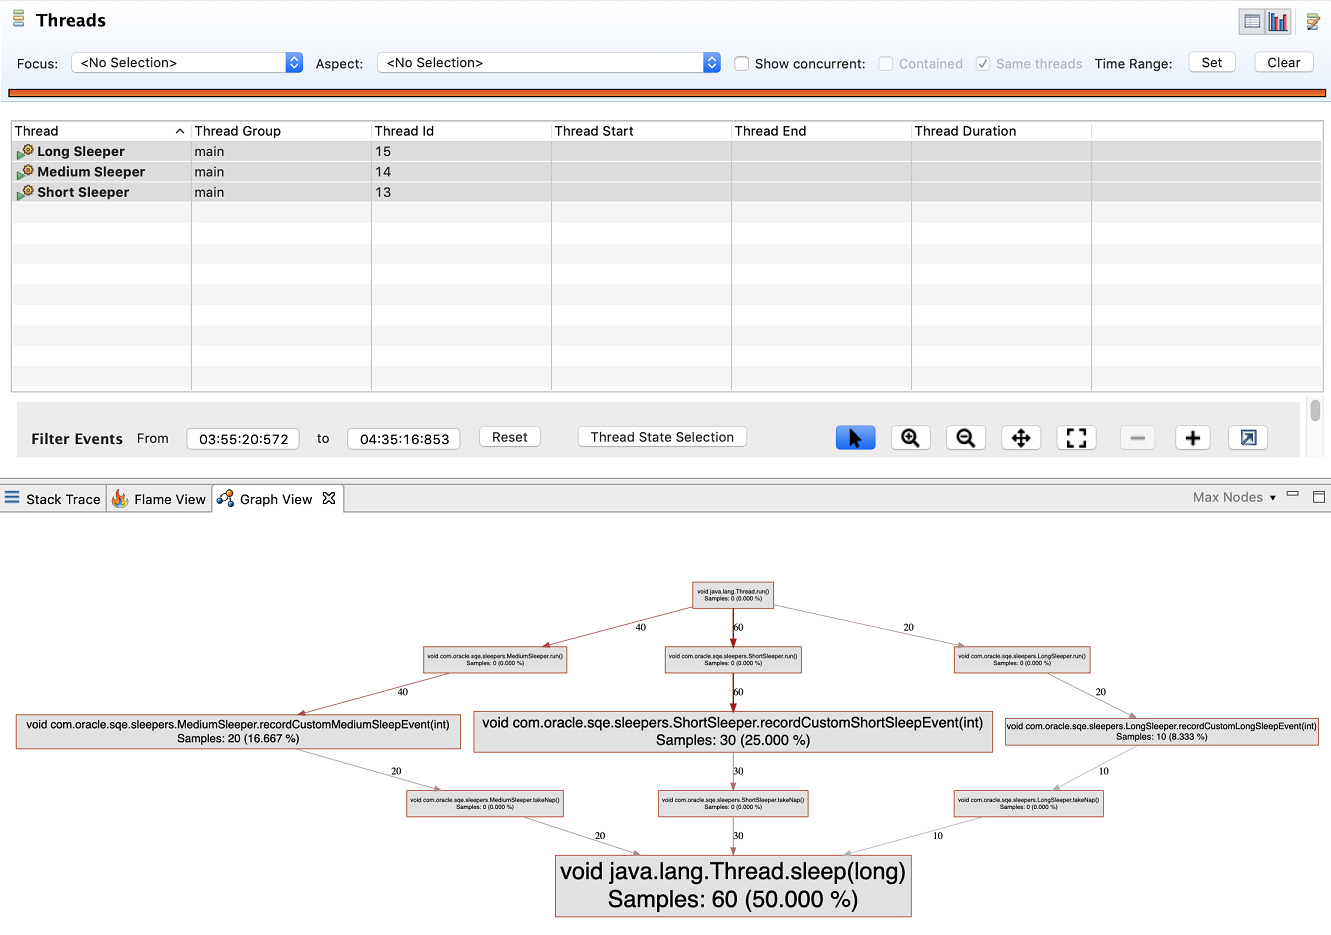
Analisi dei thread tramite Java Flight Recorder e JDK Mission Control
Analisi dei thread registrati da Java Flight Recorder tramite JDK Mission Control.

Un backend lento: dove stiamo perdendo tempo?

Facciamo un esempio concreto. Abbiamo un servizio REST che normalmente risponde in circa 50 millisecondi. Improvvisamente alcune richieste iniziano a richiedere quasi un secondo.

Dai normali log potremmo vedere qualcosa del genere:

GET /api/product/42
Response: 200
Execution time: 924 ms

Sappiamo che la richiesta è lenta, ma non sappiamo necessariamente perché.

Analizzando la registrazione JFR potremmo invece arrivare a una situazione come:

HTTP Request
     │
     ▼
Controller
     │
     ▼
Service
     │
     ├── Database ........ 18 ms
     │
     ├── JSON ............. 5 ms
     │
     └── WAITING ......... 821 ms
                              ▲
                              │
                         IL PROBLEMA

A quel punto sappiamo che il problema non è il database e non è la serializzazione JSON. Un thread sta trascorrendo gran parte del proprio tempo in attesa.

Scoprire thread bloccati e lock

Uno degli utilizzi più interessanti di JFR riguarda proprio la sincronizzazione. Mission Control può mostrare quali thread sono rimasti bloccati, per quanto tempo e soprattutto quale lock stavano tentando di acquisire.
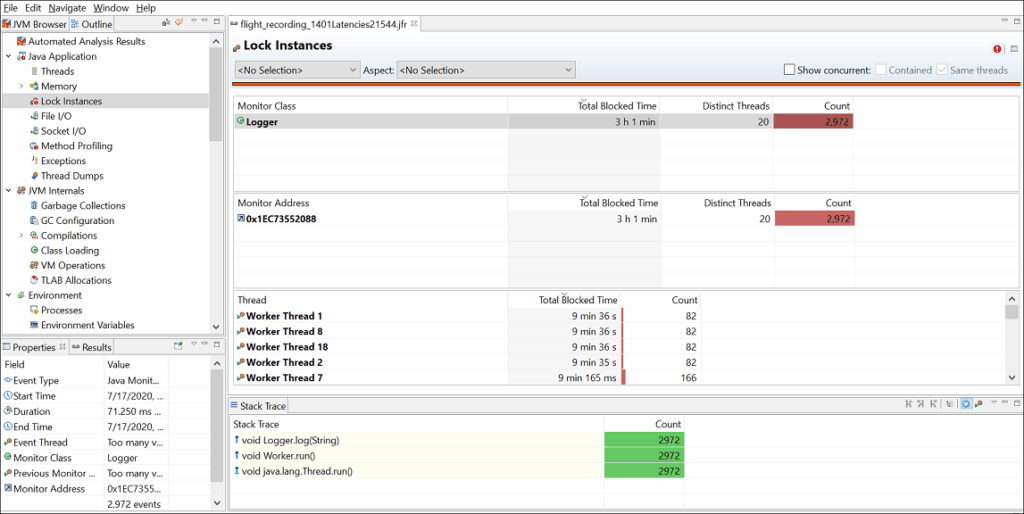
Esempio di analisi della lock contention tramite JDK Mission Control.

Nell’esempio mostrato dalla documentazione Oracle è possibile arrivare fino allo stack trace dei thread coinvolti. Questo permette di passare da una generica affermazione come:

"L'applicazione ogni tanto è lenta"

a qualcosa di decisamente più utile:

Worker Thread
     │
     ▼
Logger.log()
     │
     ▼
attesa sul monitor
     │
     ▼
thread bloccato

Garbage Collector sotto osservazione

Un’altra causa molto comune di problemi nelle applicazioni Java è il Garbage Collector. Un’applicazione può sembrare lenta non perché il codice sia necessariamente inefficiente, ma perché la JVM sta effettuando troppe operazioni di garbage collection o pause troppo lunghe.

Java Flight Recorder registra anche questi eventi.

Java Mission Control analisi Garbage Collector
JDK Mission Control può evidenziare problemi legati al Garbage Collector.

Possiamo quindi osservare le pause del GC, la pressione sulla memoria, le allocazioni e comprendere quali classi stanno producendo più oggetti.

Un piccolo esperimento

Possiamo creare volutamente un programma poco efficiente per vedere JFR al lavoro. Per esempio:

import java.util.ArrayList;
import java.util.List;

public class MemoryTest {

    public static void main(String[] args) throws Exception {

        List<String> dati = new ArrayList<>();

        for (int i = 0; i < 5_000_000; i++) {

            dati.add(
                "Oggetto temporaneo numero " + i
            );

            if (i % 100_000 == 0) {
                Thread.sleep(20);
            }
        }

        System.out.println(
            "Elementi creati: " + dati.size()
        );
    }
}

Compiliamo:

javac MemoryTest.java

e avviamo il programma con Flight Recorder:

java -XX:StartFlightRecording=filename=test.jfr,settings=profile MemoryTest

Aprendo test.jfr in Mission Control potremo osservare le allocazioni di memoria generate dal programma, l’attività del Garbage Collector e i metodi maggiormente coinvolti.

Quanto costa tutto questo in termini di performance?

Questa è probabilmente la domanda più importante. Un profiler tradizionale può influenzare l’applicazione che sta misurando. Java Flight Recorder è invece stato progettato fin dall’inizio per avere un overhead molto contenuto.

La documentazione Oracle relativa a Java 11 indica che una normale registrazione di profiling con le impostazioni standard rimane generalmente sotto il 2% di overhead nella maggior parte delle applicazioni, mentre una registrazione continua standard può avere un impatto non misurabile in molti casi.

Naturalmente esistono eventi più costosi da raccogliere e una configurazione aggressiva può aumentare l’overhead. JFR non significa quindi “costo sempre zero”, ma è stato progettato proprio pensando anche agli ambienti di produzione.

Default e Profile

Java Flight Recorder mette a disposizione diverse configurazioni. Due concetti importanti da conoscere sono default e profile.

default
   │
   ├── meno eventi
   ├── overhead molto basso
   └── adatto anche a registrazioni lunghe


profile
   │
   ├── più informazioni
   ├── maggiore dettaglio
   └── ideale per analisi brevi

Per una registrazione diagnostica breve possiamo quindi utilizzare:

java -XX:StartFlightRecording=duration=2m,settings=profile,filename=profiling.jfr \
     -jar applicazione.jar

La cosa più interessante: possiamo creare i nostri eventi

JFR non è limitato agli eventi prodotti internamente dalla JVM. È possibile definire anche eventi applicativi personalizzati.

Per esempio potremmo voler misurare un’operazione particolarmente importante del nostro backend.

import jdk.jfr.Event;
import jdk.jfr.Label;
import jdk.jfr.Name;

@Name("cutalab.ProductRequest")
@Label("Product Request")
public class ProductRequestEvent extends Event {

    @Label("Product ID")
    String productId;
}

Nel nostro service potremmo quindi scrivere:

ProductRequestEvent event = new ProductRequestEvent();

event.productId = "42";

event.begin();

try {

    productService.loadProduct("42");

} finally {

    event.end();
    event.commit();
}

Da quel momento quella particolare operazione può comparire all’interno della registrazione JFR insieme agli eventi della JVM.

È una caratteristica estremamente potente perché permette di correlare gli eventi dell’applicazione con ciò che stava avvenendo nello stesso momento nella JVM.

Dai log alla telemetria della JVM

I log continuano naturalmente ad essere fondamentali, ma raccontano soltanto ciò che abbiamo deciso preventivamente di scrivere.

LOGGER.info("Loading product {}", id);

Se non abbiamo inserito il log giusto nel punto giusto, quell’informazione non esisterà.

Flight Recorder affronta il problema da una prospettiva completamente diversa: raccoglie gli eventi del runtime.

                 APPLICAZIONE

                      │
           ┌──────────┴──────────┐
           │                     │
           ▼                     ▼
          LOG                   JFR
           │                     │
   ciò che decidiamo       ciò che accade
     di registrare           nella JVM

Perché Java Flight Recorder è una delle funzionalità più interessanti di Java 11

Java 11 ha introdotto numerose migliorie importanti, ma Java Flight Recorder rappresenta qualcosa di diverso.

Non modifica semplicemente il modo in cui scriviamo una riga di codice: modifica il modo in cui possiamo osservare un’applicazione Java mentre sta funzionando.

Davanti a un backend lento possiamo registrare la JVM, riprodurre il problema e analizzare successivamente cosa è realmente successo.

Problema in produzione
        │
        ▼
Flight Recording
        │
        ▼
file .jfr
        │
        ▼
JDK Mission Control
        │
        ▼
Thread / CPU / Memory / GC / Lock / I/O
        │
        ▼
causa del problema

Ed è proprio per questo che il nome Flight Recorder è particolarmente azzeccato.

Quando qualcosa va storto non dobbiamo necessariamente cercare di indovinare cosa sia successo.

Possiamo aprire la scatola nera della JVM e guardare.
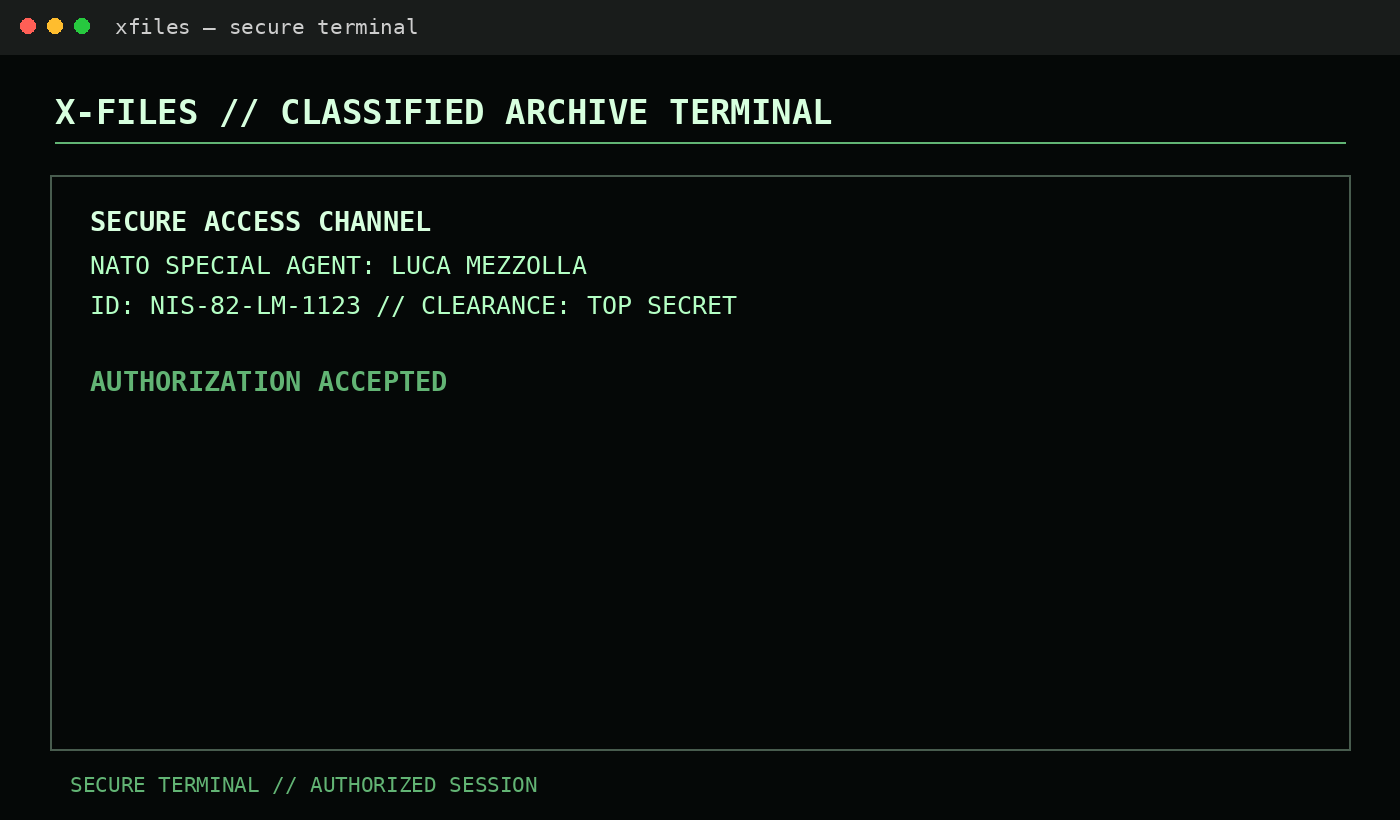
Realizzare un archivio stile X-Files in C: terminale, SQLite e gestione dei documenti

Uno dei progetti personali che mi ha divertito maggiormente negli ultimi tempi è stato lo sviluppo di una piccola applicazione scritta interamente in C e ispirata all’atmosfera di X-Files: un archivio riservato accessibile da terminale, con autenticazione, documenti classificati e persistenza dei dati tramite SQLite.

L’obiettivo non era semplicemente realizzare un programma CRUD, ma costruire un’applicazione che avesse una propria identità visiva pur rimanendo completamente all’interno di una console. Il progetto è stato anche un buon esercizio per lavorare con aspetti del C che normalmente vengono nascosti dai framework e dai linguaggi di più alto livello: gestione diretta del terminale, input da tastiera, segnali del sistema operativo, memoria, file e accesso a un database.

In questo articolo vediamo alcuni dei passaggi più significativi che hanno caratterizzato la realizzazione del progetto.

1. Progettare il flusso dell’applicazione

Prima ancora di scrivere il codice è stato necessario definire il flusso principale dell’applicazione. Il programma presenta inizialmente una schermata di benvenuto, successivamente richiede l’autenticazione dell’utente e permette di selezionare la sorgente dell’archivio.

Una volta entrati nel sistema viene mostrata l’interfaccia principale dalla quale è possibile consultare, creare, modificare, cercare ed eliminare documenti.

Una versione semplificata del ciclo principale può essere rappresentata così:

int main(void)
{
    initialize_terminal();

    while (1) {

        show_welcome_screen();

        if (!login()) {
            continue;
        }

        int source = select_database_source();

        if (source == SOURCE_EXIT) {
            break;
        }

        open_archive(source);
        run_application();
        close_archive();
    }

    restore_terminal();

    return 0;
}

Questa struttura permette di mantenere separate le varie responsabilità del programma. Il main() si limita a coordinare il flusso generale, mentre le singole funzionalità vengono delegate a funzioni specifiche.

2. Trasformare il terminale in un’interfaccia

Una delle parti più interessanti del progetto è stata la costruzione dell’interfaccia. Nonostante si tratti di un’applicazione console, l’obiettivo era ottenere qualcosa di più vicino a un vecchio terminale governativo che a un normale programma da riga di comando.

Per ottenere questo risultato si possono utilizzare le sequenze ANSI, che permettono di controllare il cursore, cancellare lo schermo e modificare alcuni attributi del testo.

Per esempio, per cancellare completamente il terminale e riportare il cursore nell’angolo superiore sinistro:

printf("\033[2J");
printf("\033[H");

Le due operazioni possono essere combinate:

printf("\033[2J\033[H");

È inoltre possibile definire alcuni colori:

#define COLOR_GREEN "\033[32m"
#define COLOR_RED   "\033[31m"
#define COLOR_WHITE "\033[37m"
#define COLOR_RESET "\033[0m"

printf(COLOR_GREEN "SYSTEM ONLINE" COLOR_RESET "\n");

Con queste semplici istruzioni è già possibile creare messaggi di sistema, segnalazioni di errore e intestazioni con un aspetto molto più caratteristico.

3. Leggere dinamicamente le dimensioni del terminale

Un’interfaccia costruita manualmente presenta però un problema importante: la finestra del terminale può essere ridimensionata in qualsiasi momento.

Per evitare che bordi, separatori e contenuti vengano visualizzati in maniera errata, il programma deve conoscere il numero di righe e colonne disponibili.

Su sistemi Unix-like possiamo utilizzare ioctl():

#include <sys/ioctl.h>
#include <unistd.h>

void get_terminal_size(int *rows, int *cols)
{
    struct winsize size;

    ioctl(STDOUT_FILENO, TIOCGWINSZ, &size);

    *rows = size.ws_row;
    *cols = size.ws_col;
}

Queste informazioni possono essere utilizzate per calcolare dinamicamente la lunghezza delle linee, centrare un titolo oppure stabilire quanti documenti possono essere visualizzati contemporaneamente.

4. Creare un header persistente

Nel progetto ho voluto mantenere un’intestazione sempre visibile nella parte superiore dello schermo. L’header contiene informazioni come l’identità dell’agente e la sorgente dati attualmente utilizzata.

Una versione semplificata potrebbe essere la seguente:

void draw_header(const char *agent, const char *database)
{
    int rows;
    int cols;

    get_terminal_size(&rows, &cols);

    printf("\033[H");

    printf("+");

    for (int i = 0; i < cols - 2; i++) {
        printf("-");
    }

    printf("+\n");

    printf(" NATO SPECIAL AGENT: %s\n", agent);
    printf(" DATABASE: %s\n", database);

    for (int i = 0; i < cols; i++) {
        printf("-");
    }

    printf("\n");
}

Il punto interessante è che la larghezza dell’header non è fissa, ma viene calcolata in base alle dimensioni reali della finestra.

5. Leggere la tastiera senza premere Invio

Un programma interattivo da terminale diventa molto più interessante quando può reagire immediatamente alla pressione dei tasti.

Normalmente il terminale lavora in modalità canonica: ciò significa che ciò che viene digitato viene consegnato al programma soltanto dopo la pressione del tasto Invio.

Utilizzando termios è possibile modificare temporaneamente questo comportamento:

#include <termios.h>
#include <unistd.h>

int read_key(void)
{
    struct termios old_state;
    struct termios new_state;

    tcgetattr(STDIN_FILENO, &old_state);

    new_state = old_state;
    new_state.c_lflag &= ~(ICANON | ECHO);

    tcsetattr(STDIN_FILENO, TCSANOW, &new_state);

    int ch = getchar();

    tcsetattr(STDIN_FILENO, TCSANOW, &old_state);

    return ch;
}

In questo modo il programma riceve immediatamente il carattere digitato dall’utente e può reagire senza aspettare Invio.

6. Implementare Ctrl+S nell’editor

Tra le funzionalità che volevo inserire c’era anche un piccolo editor integrato per creare e modificare i documenti dell’archivio.

Per rendere l’utilizzo più naturale ho scelto di utilizzare Ctrl+S come comando di salvataggio, esattamente come accade nei normali editor di testo.

Il carattere generato dalla combinazione Ctrl+S corrisponde al valore ASCII 19:

#define CTRL_S 19

int key = read_key();

if (key == CTRL_S) {
    save_document();
}

Questo piccolo dettaglio cambia molto l’esperienza di utilizzo, perché l’applicazione comincia a comportarsi più come un vero programma interattivo che come una semplice sequenza di richieste tramite scanf().

7. Utilizzare SQLite come archivio locale

Per memorizzare i documenti ho scelto SQLite. La scelta è particolarmente adatta a questo tipo di progetto perché SQLite non richiede l’installazione di un database server.

L’intero archivio viene memorizzato all’interno di un singolo file, nel nostro caso xfiles.db.

L’apertura del database richiede poche righe:

#include <sqlite3.h>

sqlite3 *db;

int result = sqlite3_open("xfiles.db", &db);

if (result != SQLITE_OK) {

    fprintf(
        stderr,
        "Database error: %s\n",
        sqlite3_errmsg(db)
    );

    return 1;
}

Un aspetto molto comodo è che, se il file xfiles.db non esiste, SQLite può crearlo automaticamente. Questo permette di distribuire l’applicazione senza dover preparare manualmente il database.

8. Creare la tabella dei documenti

La struttura iniziale del database può essere estremamente semplice:

CREATE TABLE IF NOT EXISTS documents (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    title TEXT NOT NULL,
    content TEXT NOT NULL,
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP
);

Ogni documento possiede quindi un identificativo univoco, un titolo, il contenuto e la data di creazione.

La tabella può essere inizializzata direttamente dal programma C:

const char *sql =
    "CREATE TABLE IF NOT EXISTS documents ("
    "id INTEGER PRIMARY KEY AUTOINCREMENT,"
    "title TEXT NOT NULL,"
    "content TEXT NOT NULL,"
    "created_at DATETIME DEFAULT CURRENT_TIMESTAMP"
    ");";

char *error = NULL;

if (sqlite3_exec(db, sql, NULL, NULL, &error) != SQLITE_OK) {

    fprintf(stderr, "%s\n", error);

    sqlite3_free(error);
}

Questo significa che l’applicazione è in grado di preparare autonomamente la propria struttura dati durante il primo avvio.

9. Inserire nuovi documenti in modo sicuro

Per inserire i documenti nel database è preferibile utilizzare i prepared statement invece di costruire manualmente le query SQL concatenando stringhe.

const char *sql =
    "INSERT INTO documents(title, content) "
    "VALUES (?, ?);";

sqlite3_stmt *stmt;

sqlite3_prepare_v2(
    db,
    sql,
    -1,
    &stmt,
    NULL
);

sqlite3_bind_text(
    stmt,
    1,
    title,
    -1,
    SQLITE_TRANSIENT
);

sqlite3_bind_text(
    stmt,
    2,
    content,
    -1,
    SQLITE_TRANSIENT
);

sqlite3_step(stmt);

sqlite3_finalize(stmt);

I valori vengono associati ai placeholder della query separatamente dal comando SQL. Oltre a rendere il codice più ordinato, questo approccio evita diversi problemi legati all’escaping delle stringhe.

10. Costruire l’indice dei documenti

Una delle schermate principali del programma è l’indice dell’archivio, nel quale vengono mostrati l’identificativo e il titolo dei documenti presenti nel database.

La query necessaria è molto semplice:

SELECT id, title
FROM documents
ORDER BY id DESC;

Dal codice C possiamo leggere i risultati riga per riga:

sqlite3_stmt *stmt;

sqlite3_prepare_v2(
    db,
    "SELECT id, title FROM documents ORDER BY id DESC;",
    -1,
    &stmt,
    NULL
);

while (sqlite3_step(stmt) == SQLITE_ROW) {

    int id =
        sqlite3_column_int(stmt, 0);

    const unsigned char *title =
        sqlite3_column_text(stmt, 1);

    printf(
        "%04d  %s\n",
        id,
        title
    );
}

sqlite3_finalize(stmt);

Nel progetto l’elenco viene anche paginato, perché il numero di documenti visualizzabili deve dipendere dall’altezza disponibile nel terminale.

11. Implementare la ricerca

Un archivio diventa rapidamente poco utile se non permette di cercare al suo interno. Per questo è stata aggiunta una funzione di ricerca sia nel titolo sia nel contenuto dei documenti.

Una query possibile è:

SELECT id, title
FROM documents
WHERE title LIKE ?
   OR content LIKE ?
ORDER BY id DESC;

Il testo inserito dall’utente può essere trasformato in un pattern SQL:

char pattern[256];

snprintf(
    pattern,
    sizeof(pattern),
    "%%%s%%",
    search_text
);

Se l’utente cerca la parola alien, il pattern utilizzato da SQLite diventerà %alien%, permettendo di trovare la parola anche all’interno di una frase più lunga.

12. Aggiornare un documento esistente

La modifica di un documento utilizza una logica molto simile all’inserimento. La differenza principale consiste nell’identificazione del record tramite il suo ID.

UPDATE documents
SET title = ?,
    content = ?
WHERE id = ?;

Anche in questo caso è utile utilizzare un prepared statement:

sqlite3_bind_text(
    stmt,
    1,
    title,
    -1,
    SQLITE_TRANSIENT
);

sqlite3_bind_text(
    stmt,
    2,
    content,
    -1,
    SQLITE_TRANSIENT
);

sqlite3_bind_int(
    stmt,
    3,
    document_id
);

13. Eliminare un documento

L’eliminazione è probabilmente l’operazione CRUD più semplice:

DELETE FROM documents
WHERE id = ?;

Dal punto di vista dell’interfaccia, però, è importante chiedere una conferma prima di eseguire definitivamente l’operazione.

Questo evidenzia un aspetto importante dello sviluppo: spesso la parte più interessante di un’applicazione non è la query SQL in sé, ma il modo in cui viene costruito il flusso di interazione con l’utente.

14. Gestire il resize della finestra

Durante lo sviluppo è emerso anche il problema della gestione del ridimensionamento della finestra.

Sui sistemi Unix viene generato il segnale SIGWINCH quando le dimensioni del terminale cambiano.

È quindi possibile intercettarlo:

#include <signal.h>

volatile sig_atomic_t resized = 0;

void handle_resize(int signal)
{
    resized = 1;
}

int main(void)
{
    signal(SIGWINCH, handle_resize);

    /* ... */

    return 0;
}

Il signal handler non ridisegna direttamente tutta l’interfaccia, ma si limita a modificare una variabile. Sarà poi il normale ciclo dell’applicazione a rilevare il cambiamento e aggiornare lo schermo.

Questo approccio è più sicuro perché all’interno di un signal handler è opportuno eseguire il minor numero possibile di operazioni.

15. Logout senza terminare il programma

Un’altra scelta progettuale è stata quella di distinguere nettamente il comando di logout dall’uscita dal programma.

Con il logout la sessione corrente termina, il database viene chiuso e l’utente viene riportato alla schermata iniziale.

Il processo rimane quindi attivo:

while (application_running) {

    if (!login()) {
        continue;
    }

    open_archive();

    int action = run_application();

    close_archive();

    if (action == ACTION_EXIT) {
        application_running = 0;
    }
}

Questa distinzione rende il programma più simile a un vero sistema multi-sessione.

16. Il risultato finale

Alla fine il progetto è diventato molto più di un semplice esercizio con SQLite. È un piccolo esempio di come sia possibile costruire un’applicazione interattiva utilizzando quasi esclusivamente strumenti messi a disposizione direttamente dal linguaggio C e dal sistema operativo.

Il programma permette di autenticarsi, selezionare l’archivio, consultare una lista paginata di documenti, aprirli, crearli, modificarli, salvarli tramite Ctrl+S, eliminarli e cercarli. Tutto questo viene presentato attraverso un’interfaccia testuale ispirata ai vecchi terminali investigativi e ai database classificati delle serie televisive degli anni Novanta.

Cosa mi ha lasciato questo progetto

Per chi proviene da linguaggi come Java, lavorare nuovamente con il C è particolarmente interessante. Molti comportamenti che normalmente vengono gestiti automaticamente devono essere affrontati direttamente: l’input della tastiera, i buffer, i segnali, il terminale, la memoria e il collegamento con librerie esterne.

Ed è proprio questo uno degli aspetti che trovo più affascinanti del linguaggio C: dietro a poche righe apparentemente semplici c’è spesso un rapporto molto diretto con il sistema operativo e con il funzionamento reale della macchina.

Il progetto X-Files nasce principalmente come esperimento personale e come omaggio a un certo immaginario informatico, ma è diventato anche un ottimo laboratorio per riscoprire concetti fondamentali della programmazione di sistema.

A volte non serve costruire un progetto enorme per imparare qualcosa di nuovo. Può bastare un terminale, un database SQLite, qualche centinaio di righe in C e l’idea di stare consultando un archivio che probabilmente non dovrebbe essere accessibile.

Vaadin 25.2: le principali novità della nuova versione

Vaadin continua l’evoluzione della serie 25 con Vaadin 25.2, una release particolarmente interessante per chi sviluppa applicazioni web enterprise in Java.

La versione stabile più recente della piattaforma è attualmente Vaadin 25.2.7, mentre la 25.3 è ancora indicata nella roadmap come prossima release. Vaadin 25 rappresenta ormai la versione consigliata per i nuovi progetti e porta con sé una base tecnologica decisamente moderna: Java 21+, Spring Boot 4, Spring Framework 7, Jakarta EE 11, React 19 e Node.js 24.

Con la 25.2, però, Vaadin non si limita ad aggiornare le dipendenze: introduce nuove API che permettono di utilizzare funzionalità native del browser direttamente da Java, migliora il modello reattivo basato sui Signals, aggiunge nuovi componenti e aumenta la sicurezza predefinita delle applicazioni.

API del browser direttamente da Java

Una delle novità più interessanti di Vaadin 25.2 riguarda l’accesso alle API native del browser.

Tradizionalmente, quando una applicazione Vaadin aveva bisogno di interagire con determinate funzionalità del browser, era spesso necessario ricorrere a JavaScript oppure a chiamate tramite executeJs().

Con Vaadin 25.2 diverse di queste funzionalità diventano accessibili direttamente dal codice Java server-side.

Tra le API disponibili troviamo geolocalizzazione, clipboard, modalità fullscreen, Screen Wake Lock, Page Visibility, Web Share e gestione dell’orientamento dello schermo.

Per esempio, copiare un testo negli appunti può diventare molto semplice:

Button copy = new Button("Copia");

Clipboard.onClick(copy)
        .writeText("Hello, Vaadin!");

Non è quindi necessario scrivere JavaScript personalizzato per una funzionalità così comune.

Lo stesso principio vale per la geolocalizzazione. Vaadin permette di ottenere la posizione corrente del browser oppure di seguirne continuamente gli aggiornamenti tramite watchPosition().

Questo approccio rafforza ulteriormente uno dei principali punti di forza di Vaadin Flow: permettere allo sviluppatore Java di lavorare il più possibile all’interno dello stesso ecosistema senza dover continuamente passare da Java a JavaScript.

Signals sempre più centrali

Signals, diventati production-ready con Vaadin 25.1, vengono ulteriormente integrati nel framework con la versione 25.2.

L’obiettivo è rendere più semplice la gestione dello stato reattivo dell’interfaccia.

Un componente può, ad esempio, aggiornare automaticamente proprietà come visibilità, abilitazione o valore quando cambia il Signal al quale è collegato.

Vaadin mette a disposizione API come:

bindVisible(...)
bindEnabled(...)
bindValue(...)

Il paradigma diventa interessante soprattutto nelle interfacce complesse, dove diversi componenti dipendono dallo stesso stato.

Anche strutture dati più articolate possono essere gestite utilizzando ListSignal e Signal.effect().

Un esempio molto semplice:

ListSignal<String> items = new ListSignal<>();

Grid<String> grid = new Grid<>();

Signal.effect(
        grid,
        () -> grid.setItems(items.getValues().toList())
);

Quando cambia il contenuto del Signal, l’interfaccia può quindi reagire automaticamente senza dover costruire manualmente tutta la logica di sincronizzazione.

Nuovi componenti pronti per la produzione

Vaadin 25.2 porta inoltre alla disponibilità generale diversi componenti precedentemente presenti come Preview.

Tra quelli più interessanti troviamo SliderBadgeMaster-Detail Layout e la nuova architettura modulare del componente Upload.

Slider dispone anche di implementazioni specifiche come IntegerSliderDecimalSliderIntegerRangeSlider e DecimalRangeSlider.

Badge permette invece di rappresentare facilmente stati e notifiche, compresi indicatori di successo, warning ed errore.

Il Master-Detail Layout è particolarmente utile nelle applicazioni gestionali: permette di realizzare interfacce nelle quali una lista principale e il relativo dettaglio vengono visualizzati fianco a fianco, adattando automaticamente il comportamento sugli schermi più piccoli.

Anche Upload diventa più modulare. Invece di utilizzare necessariamente un singolo componente monolitico, è possibile comporre l’interfaccia utilizzando elementi come UploadManagerUploadButtonUploadDropZone e UploadFileList.

Maggiore sicurezza di default

Vaadin 25.2 introduce anche modifiche importanti dal punto di vista della sicurezza.

Le URL utilizzate da componenti come AnchorIFrame e Page.open() vengono ora validate automaticamente. Schemi potenzialmente pericolosi come javascript: vengono quindi rifiutati di default.

Anche la protezione contro il clickjacking viene rafforzata: Vaadin invia automaticamente l’header X-Frame-Options.

È stata inoltre migliorata la gestione di HTML proveniente da fonti non attendibili attraverso il supporto alle Safelist di jsoup.

Interessante anche la protezione relativa alla supply chain npm: per impostazione predefinita Vaadin evita di installare pacchetti npm pubblicati da meno di un giorno. L’obiettivo è lasciare un intervallo di tempo nel quale eventuali pacchetti compromessi possano essere identificati e rimossi prima di entrare automaticamente nelle build delle applicazioni.

AI sempre più integrata

L’intelligenza artificiale entra progressivamente anche nella piattaforma Vaadin.

Vaadin 25.2 introduce, ancora in Preview, GridAIControllerChartAIController e FormAIController.

L’idea è permettere agli utenti di interagire con parti dell’interfaccia attraverso il linguaggio naturale.

Con GridAIController e ChartAIController, per esempio, una descrizione testuale può essere utilizzata per generare una query SQL e configurare automaticamente una Grid o un grafico.

FormAIController punta invece alla compilazione automatica dei form partendo da testo, documenti o immagini.

Si tratta ancora di funzionalità sperimentali e le relative API potrebbero cambiare, ma mostrano chiaramente la direzione che Vaadin sta seguendo.

Test di carico partendo dai test esistenti

Un’altra novità interessante riguarda i test.

Vaadin 25.2 permette di trasformare test end-to-end realizzati con TestBench o Playwright in test di carico basati su Grafana k6.

Il processo registra il traffico HTTP prodotto dal test, genera un file HAR e successivamente lo converte in uno script k6 tenendo conto di aspetti specifici di Vaadin come session ID, token CSRF, Push ID e UI ID.

In questo modo gli stessi scenari utilizzati per verificare funzionalmente l’applicazione possono diventare una base per effettuare test con numerosi utenti virtuali. Questa funzionalità è attualmente sperimentale e la parte di load testing basata su TestBench richiede una sottoscrizione commerciale Vaadin.

Una piattaforma sempre più Java-oriented

Vaadin 25.2 conferma soprattutto la direzione intrapresa dalla versione 25: ridurre le particolarità specifiche del framework e avvicinarsi maggiormente agli standard dell’ecosistema Java e del Web moderno.

L’accesso alle funzionalità del browser direttamente da Java è probabilmente una delle novità più significative per chi utilizza Vaadin Flow. A questo si aggiungono Signals, una maggiore sicurezza predefinita, nuovi componenti e una progressiva integrazione dell’intelligenza artificiale.

Per applicazioni enterprise nelle quali gran parte della business logic è già sviluppata in Java, Vaadin continua quindi a proporre un approccio particolare ma interessante: costruire applicazioni web moderne mantenendo Java come linguaggio principale non soltanto nel backend, ma anche nella gestione dell’interfaccia utente.

Con Vaadin 25 questa filosofia sembra diventare ancora più evidente.

CUTALAB

Ho aperto cutalab senza l’idea di creare un blog dedicato a un unico argomento.

L’informatica sarà sicuramente una delle parti principali di questo spazio. È il settore in cui lavoro e uno degli ambiti che continuo a studiare con maggiore interesse. Vorrei parlare soprattutto di programmazione, in particolare di C e Java, di database, sviluppo software e del mondo Linux e di altri linguaggi.

Non vorrei però limitarmi alla tecnologia.

Mi interessa la scienza in generale e mi piacerebbe utilizzare questo blog anche per raccogliere appunti, approfondimenti, esperimenti e curiosità sugli argomenti che incontro e che mi spingono a voler capire qualcosa in più.

Ci sarà spazio anche per i libri.

E probabilmente finirò per parlare anche di interessi un po’ meno convenzionali: storia e filosofia e testi legati alle tradizioni.

Forse è proprio questo il motivo per cui nasce cutalab.

Un laboratorio personale.

Un posto dove mettere insieme codice, sistemi operativi, database, scienza, libri, idee e curiosità apparentemente molto distanti tra loro, indagando anche nel mio spazio interiore.

Non so ancora esattamente che forma prenderà questo spazio.

Ed è probabilmente la parte più interessante.

Benvenuti su cutalab.